

—
DEV TRENDS / DAILY DISCOVERIES
Apr 30, 2026 · What developers are building
Daily discoveries from developer communities, independent makers, and open source.

—
—
—

—
CoffeeTrans: 几分钟内为视频生成 Netflix 级别字幕
CoffeeTrans: 一键式为音视频生成 Netflix 级别的精准时间轴字幕 大家好,很高兴在这里向各位介绍我的新产品 CoffeeTrans。这是一款针对音频或者视频的上传、字幕识别、翻译、导出的一键式转录翻译平台 为什么开发 CoffeeTrans ? 我的大学专业是计算机,接触过很多国外高质量课程,社区贡献了很多高质量的课程翻译,但是更多的课程没有人搬运,我自己英语还做不到流畅的正常速度观看吸收,因此想做一个自己的翻译工具 我知道社区有一些开源的实现,我自己也跑过,老实说对于普通人来说存在一些问题:安装有门槛容易包错、需要比较好的机器性能才能跑比较大的 Whisper 模型,转录速度比不够快、翻译经常抽风,跑到一半直接断了、字幕烧录非常的吃机器性能,一套流程下来耗时挺长的,当然如果是偶尔使用还是可以接受的 又有很多人会说了,这不就调用一下转录模型和大模型进行翻译吗?是的,这个承认,但是多少产品不是这样呢,一个功能到一个产品是有很多坑要踩的 另外就是国外也有很多类似的平台,不过很多聚焦于全视频处理平台,转录和翻译是其中的一小部分,额度很小并且比较贵,对于专门做转录和翻译的选择会更少 最后,因为自己也想搓一个就做了 为什么取名叫 CoffeeTrans ? 我希望泡杯咖啡的时间就能完成高质量的翻译过程,所以就叫 CoffeeTrans 了 核心特点 快速翻译:相比本地 Whisper 转录,使用 CoffeeTrans 的转录更快,2小时的视频可以在几分钟内转录完成 批量处理:可以上传多个文件同时转录翻译 多语言支持:这应该是转录翻译的基本功能 高质量翻译:基于最新的大语言模型,翻译质量有保障。 上下文感知:在翻译之前会整体扫描一遍上下文,自动提取术语、关系等,后续翻译都会携带上下文,保证翻译的连续性和准确性 多格式支持:支持常见的音视频格式 精准时间轴:生成的字幕时间轴非常准确,对于需要处理字幕的人来说非常有用 字幕导出:支持导出为 srt 方便二次修改 支持一次翻译为多种语言:可以一次性选择翻译为多种目标语言,极大的减少工作量,节省 credits 智能去除语气词:智能去除语气词,让字幕更加自然流畅
Original
—
PaperQuay 自建文献库-Agent管理文献-瞬时翻译跳转-维持阅读心流-极轻量
PaperQuay:桌面端优先的 AI 文献管理工具 PaperQuay 是一个本地优先的 AI 辅助文献管理软件,面向学生、研究人员和论文写作者,支持 Windows / macOS / Linux。 它不只是 PDF 阅读器,也不是单纯的 Zotero 插件,而是希望把「文献管理、PDF 阅读、批注笔记、全文翻译、论文速读和 Agent 辅助整理」整合到同一个桌面工作流中。 Github链接: 亮点 本地优先:文献数据使用 SQLite 保存,PDF 存储在用户本地文件夹中。 AI 辅助阅读:支持论文概览、全文翻译、划词翻译和结构块级翻译缓存。 阅读体验友好:保留原始 PDF,需要时可快速跳转到对应译文,减少阅读心流中断。 Agent 文献管理:可辅助批量重命名、元数据补全、智能打标签、分类和论文总结。 Zotero 兼容但不依赖:支持导入 Zotero 分类、标签和 PDF,也可以独立建立本地文献库。 极轻量:基于 Tauri 2 + React + TypeScript + Rust 构建。 适合需要长期阅读、整理和利用Agent快捷筛选大量论文的用户,欢迎对 AI 文献管理、PDF 阅读器、Tauri 桌面应用感兴趣的朋友。
Original—
TiyCode,Rust+Typescript 构建的轻量级跨平台桌面 Agent,Codex、ClaudeDesktop 开源替代
TiyCode(钛可) 是一款践行 AI First 理念的桌面版 VibeCoding Agent,采用 Rust + Typescript 构建,非常轻量(安装包仅 20M+)的跨平台桌面Agent,支持windowns、mac、linux(Beta)平台,自由开放,协议友好(Apache 2.0),可作为 Codex、ClaudeCodedesktop 的开源替代品。 功能特色: 多Profile:支持不同Provider的不同模型组成多种Profile 三层模型:类CC三层模型(Primary、Auxiliary、Lightweight)组合运用 多服务商:开箱即用的13+内置模型服务商,且支持多种协议自定义服务商 良好的Coding体验设计:对话为主,搭配Git面板支持常用diff审阅等操作、Terminal 内置Runtime:内置Runtime、搭配常用tools以及terminal联动工具 扩展能力:Plugin、MCP、Skills 多语言:i18n支持,目前覆盖中英文,随时切换 产品截图:
Original—
我开发了一个开发环境管理器,一键下载/管理开发工具
一句话总结:Envis 是一款面向开发者的新一代多语言版本管理工具,它在理念上与 asdf 类似,但提供了图形用户界面( GUI ),试图降低项目环境配置的门槛。 几乎每一个开发者都会遇到这个痛点:如何方便、快速地搭建和配置开发环境。想象一个场景,在新的工作环境或者新的项目开始时,你可能需要花费大量的时间用来安装依赖包、配置环境变量、解决版本冲突问题等等,巨大的精力消耗在这些繁琐的工作上,而不是专注于开发工作本身(这个问题在国内更为突出,你可能要应对网络问题等更多未知的问题)。因此,一个方便、快速的开发环境管理器就显得尤为重要。 Envis 就是这样一款方便快捷的开发环境管理器,它通过可视化的界面进行环境变量管理,实现了一键下载 Java ,NodeJS ,Python ,MySQL 等开发工具,自动环境变量配置,环境隔离,一键版本切换,一键切换国内仓库等,非常方便! Envis 主要解决两个痛点: 给项目安装若干开发环境的痛点 不同项目切换时需要切换若干开发环境的痛点 Envis 是怎么解决这些痛点的呢?关键在于 Envis 为每一个项目都定制了一套各自的开发环境,例如项目 A 使用 NodeJS 14 ,Java 8 ,MySQL ;而项目 B 使用 NodeJS 20 ,Java 11 ,MongoDB ,这里需要创建两个开发环境,然后分别配置服务。 环境会有一个“激活”的概念,其原理就是点击激活后,会将环境下的服务程序写入到终端配置文件中,这样就能在全局使用了,激活一个环境时会自动激活旗下的所有服务,不过同时只能有一个环境处于激活状态(其实多个环境也是可以同时启动的,只是一般而言没有必要,因为不同环境的不同版本的服务会相互冲突)。启动环境完毕后,打开终端,终端会读取终端配置文件导入环境变量,从而就能处于你想要的环境啦! Envis 是怎么管理服务程序的呢? Envis 能自动从各个软件源下载对应的软件,并存储到统一的文件夹下(默认在家目录下),但是你也可以在设置窗口调整该位置,所有下载的软件程序都放到这个文件夹下,不会污染系统环境。具体到某一个服务而言,每个服务都会有一个面板,方便操作,例如 NodeJS 的面板上可以方便地设置仓库地址,prefix 前缀,查看全局包等等,非常的实用。 另外,Envis 还支持了黑夜白天模式,中英文切换,不同服务还会有各自的 logo 背景图,界面还是非常漂亮的! 如果你也经历过“环境地狱”,如果你希望开发环境像“应用配置”一样简单,试试 Envis —— 让切换整套开发环境,只需一次点击。 开源 Github
Original—
SpineDigest:把一本书读薄,同时保留它的骨架
简要 项目名:SpineDigest GitHub: 协议:Apache2.0 SpineDigest 是一个面向长篇书籍的命令行工具,可以把 EPUB、Markdown、TXT 交给 LLM 处理,生成压缩后的文本、EPUB,或者可复用的 .sdpub 归档。 它的目标不是简单生成一段“读后感式摘要”,而是尽量保留一本书的骨架:章节结构、关键知识点、知识点之间的关系,以及最终可以阅读的压缩文本。 Terminal 为什么做这个项目 现在很多人用 AI 总结文章,短文本效果很好,但一到整本书就容易出问题。 常见问题不是上下文窗口不够大,而是 AI 不知道该怎么取舍。一本书里可以保留的东西太多了:论点、例子、人物变化、概念定义、证据链、章节关系。你不告诉它目的,它只能给出一个看起来面面俱到、实际没什么用的摘要。 比如,同一本书可以有完全不同的摘要目标: 只关心作者提出了哪些实用方法 只关心核心论证链条是否成立 只关心故事里人物关系和情绪变化 只关心能不能快速复习考试重点 这些目标对应的“重要内容”是不一样的。SpineDigest 解决的是这个问题:让你的阅读目的贯穿整个处理过程,而不是只在最后让模型随便概括一下。 核心思路 SpineDigest 不是把一本书一次性塞给模型,然后等一个摘要。 它大致分成三步。 第一步,逐段阅读原文,提取一个个独立的信息单元,可以理解成阅读时真正落到注意力里的知识点。 第二步,用传统算法把这些知识点连成图。相关的知识点会被聚到一起,再按照原文顺序串成线索。项目里把这样的线索称为 snake,它像一条线一样穿过原文,把同一主题下的内容串起来。 第三步,再交给 LLM 做压缩。但这里不是单个模型直接写完,而是一个类似答辩的过程:一个角色负责写摘要,多个“教授”分别拿着不同的线索去质询它。哪里漏了,哪里太轻,哪里偏离了用户给的目标,都会被反复指出。最后出来的摘要,是多轮压力下的折中结果。 这个过程有一个好处:摘要不会只保留模型最容易注意到的开头和结尾,也不会把中间章节一笔带过。 功能特性 支持 EPUB、Markdown、TXT 输入 支持输出 Markdown、TXT、EPUB 支持生成 .sdpub 归档,后续可重复导出,不需要重新调用 LLM 支持通过 prompt 指定本次摘要目标 支持 Anthropic、Google、OpenAI、OpenAIcompatible 等 LLM provider 支持命令行和 Node / TypeScript 程序化调用 支持从 stdin 读取文本,也可以输出到 stdout,方便放进脚本和自动化流程 .sdpub 可以用 Inkora 打开,查看章节拓扑和知识关系图 Open .sdpub 安装 运行要求: Node =22.12.0 如果要从 EPUB、Markdown、TXT 生成新的摘要,需要配置一个 LLM provider 如果只是重新导出已有 .sdpub,不需要 LLM 无需全局安装,可以直接试用: bash npx spinedigest help 全局安装: bash npm install g spinedigest 配置 最小配置文件默认放在: text ~/.spinedigest/config.json 示例: json { "llm": { "provider": "openai", "model": "<yourmodel" } } API key 建议通过环境变量提供: bash export SPINEDIGESTLLMAPIKEY="<yourapikey" 如果使用 OpenAI 兼容接口,还需要提供 base URL: bash export SPINEDIGESTLLMBASEURL=" 核心用法 把一本 EPUB 压缩成 Markdown: bash spinedigest input ./book.epub output ./digest.md 指定本次阅读目标: bash spinedigest input ./book.epub output ./digest.md prompt "Preserve key arguments, named entities, and decisive transitions." 先保存成 .sdpub 归档,之后再导出: bash spinedigest input ./book.epub output ./book.sdpub spinedigest input ./book.sdpub output ./digest.epub spinedigest input ./book.sdpub output ./digest.md 通过管道处理一段文本: bash cat ./chapter.txt | spinedigest inputformat txt outputformat markdown 检查 .sdpub 内容: bash spinedigest sdpub info input ./book.sdpub spinedigest sdpub toc input ./book.sdpub spinedigest sdpub list input ./book.sdpub spinedigest sdpub cat input ./book.sdpub serial 12 .sdpub 是什么 .sdpub 可以理解成 SpineDigest 的中间归档格式。 普通的 Markdown、TXT、EPUB 只能保存最终文本,而 .sdpub 会保存处理过程中的结构化结果,包括章节目录、分段摘要、知识点、线索和内部关系数据。 这有两个实际用途。 第一,后续可以重新导出,不需要重新花 token 跑一遍原书。 第二,可以用专门的阅读工具打开,直接看一本书被压缩后的结构,而不是只看一段线性的摘要文本。 目前可以用 Inkora 打开 .sdpub 文件: 适用场景 想快速读薄一本技术书或非虚构书 想把长篇材料整理成可以复习的结构化笔记 想为一本书生成不同目标下的摘要版本 想把 EPUB 处理成更短的 EPUB,放到阅读器里继续看 想把书籍处理流程接入脚本、工作流或 AI Agent 想保留中间结构,之后继续导出、检查或可视化 相关项目 如果源材料是扫描版 PDF,可以先用 PDF Craft 转成 EPUB 或 Markdown,再交给 SpineDigest: 如果目标不是摘要,而是双语阅读,可以看 EPUB Translator:
Original—
Deep Code:开源的终端 AI 编程助手,专为 DeepSeek-V4 系列模型适配
Deep Code 是一款开源的终端 AI 编程助手,专为 DeepSeekV4 系列模型适配,支持深度思考、推理强度控制以及 Agent Skills。 GitHub: < 协议:MIT 安装 Deep Code 安装 Node.js 18+ 版本。 在终端中运行以下命令: sh npm install g @vegamo/deepcodecli 然后就能在项目目录中运行deepcode命令: 配置 Deep Code 创建 ~/.deepcode/settings.json 文件,填入你的 DeepSeek API Key 和模型配置: json { "env": { "MODEL": "deepseekv4pro", "BASEURL": " "APIKEY": "sk..." }, "thinkingEnabled": true, "reasoningEffort": "max" } 从 DeepSeek 开放平台 获取你的 API Key。 核心能力与亮点 1.专为 DeepSeekV4 系列模型适配🔥 新的deepseekv4pro/flash模型在思考模式下,必须要求会话message传reasoningcontent字段,但在之前返回的message中偶尔又不包含reasoningcontent,多轮会话时原样组装历史消息就会报错。Deep Code第一时间就适配好这个问题了! 2.多模型兼容 虽然Deep Code的定位是专为 DeepSeekV4 系列模型适配,但也能支持任何其他 OpenAI 兼容模型。各家国内厂商的Coding Plan都提供OpenAI兼容接口,因此都可以接入Deep Code正常使用。 3.具备多模态能力 Deep Code支持多模态,但目前deepseekv4不支持多模态。目前多模态应用场景推荐用火山方舟的DoubaoSeed2.0pro模型,适配效果最好。 4.自带Web Search能力 众所周知,DeepSeek并不提供原生的web search的能力,这大大限制了DeepSeek用于真实开发的场景。Deep Code在工具层面上为deepseek增加了web search的能力,提升了deepseek模型的能力上限。 参考链接 Deep Code集成指南: Github仓库: Deep Code VSCode插件:
Original—
谁在招人?(2026年5月)
这里是免费的程序员招聘服务。 如果你们团队正在招人,欢迎把招聘信息发在这个帖子里面。请简要描述,岗位名称、工作地点、岗位要求、团队简介、联系方式等等。 发帖规则 请遵守以下规则,违者(很可能)被拉黑。 1. 同一团队招聘多个岗位,请写在一起,不要分成多个部分张贴。 2. 必须披露招聘公司的名称,禁止匿名招聘。 3. 谢绝中介和猎头发帖。 4. 不得发布与招聘无关的内容,且不得对公司或岗位进行评论或抱怨。 有意应聘的读者,请直接与发帖人联系。 其他 如果招聘广告想上周刊,请联系我(Email: yifeng.ruan@gmail.com )。 历史帖 程序员的招聘往往长期有效,大家别忘了查看上月的岗位。 2026年:4月,3月,2月,1月 2025年:12月,11月,10月,9月,8月,7月,6月,5月,4月,3月,2月,1月 2024年:12月,11月,10月,9月, 8月,7月,6月,5月,4月,3月,2月,1月 2023年:12月,11月,10月,9月,8月,7月,6月,5月,4月,3月,1月~2月 2022年:12月,11月,10月,9月,8月,7月,6月,5月,4月,3月,2月,1月 2021年:12月,11月,10月,9月,8月,7月,6月,5月,4月,3月,2月,1月 2020年:12月,11月,9月10月,7月8月,5月6月,4月,3月, 1月2月 2019年:12月,9月11月,8月
Original—
Fixseek:在动手修 bug / 造轮子之前,先搜索已有解决方案
Fixseek 是一个开源 CLI 工具,用来帮助开发者从错误日志和问题描述中,发现可能已经存在的工具、GitHub 项目、issue、配置 workaround 或 npm 包。 它的目标是:在动手修 bug / 造轮子之前,先搜索已有解决方案。 npm 安装: bash npm install g fixseek 使用示例: bash fixseek "Claude Code + OpenCode Go + DeepSeek 报 reasoningcontent must be passed back" 也可以使用中文输出: bash fixseek lang zh "Claude Code + DeepSeek reasoningcontent 报错" 从 stdin 读取错误日志: bash cat error.log | fixseek stdin lang zh 兼容子命令写法: bash fixseek solve "npm package ESM CommonJS error" 为什么做这个工具 很多开发问题其实已经有人解决过了,但真正困难的是:我们不知道应该搜什么关键词。 比如我最初遇到的问题是: text Claude Code + OpenCode Go + DeepSeek 报 reasoningcontent must be passed back 这个问题同时涉及 Claude Code、OpenCode Go、DeepSeek、Anthropic API、OpenAIcompatible API、reasoningcontent、thinking mode 等多个关键词。直接搜索错误日志,很容易搜不到真正相关的工具或 issue。 Fixseek 的思路是:先从错误日志或问题描述中提取关键信息,再自动生成搜索 query,寻找已有方案,并对候选结果进行排序和风险提示。 它会做什么 输入一段问题描述: bash fixseek "reasoningcontent error with Claude Code + DeepSeek + OpenCode Go" 工具会尝试完成下面的流程: text 问题描述 → 提取错误关键词、技术栈、协议/API → 生成搜索 query → 搜索候选工具 / GitHub 项目 / issue / workaround / npm 包 → 按匹配度、README 证据、维护状态和安全风险打分 → 输出推荐结果、匹配理由、风险提示和下一步建议 输出结果类似: text Fixseek — 最佳匹配 [1] ocgocc 类型:工具 匹配分:92/100 匹配原因: 命中 Claude Code 命中 OpenCode Go 命中 reasoningcontent 风险提示: 项目较新,建议先审查源码 需要本地代理配置 下一步建议: 阅读项目 README 使用本地环境测试 不要直接暴露 API key 核心功能 从错误日志中提取关键信息,例如错误 token、技术栈、版本号和约束条件。 自动生成多组搜索 query,而不是只搜索原始错误文本。 支持 mock 模式,默认不需要 API key,方便快速体验。 支持 real 模式,可通过 GitHub Search API 搜索真实仓库和 README。 对候选结果进行 0~100 分的结构化评分。 区分不同结果类型,例如 tool、issue、workaround。 输出风险提示,不会自动安装、clone 或执行未知代码。 支持中英文输出。 使用方式 默认 mock 模式,不需要 API key: bash fixseek "reasoningcontent error with Claude Code + DeepSeek + OpenCode Go" 补充技术栈上下文: bash fixseek stack "Node.js,Docker" "container networking issue" 真实 GitHub 搜索模式需要配置 GITHUBTOKEN: bash export GITHUBTOKEN=yourtokenhere fixseek real provider github \ "reasoningcontent error with Claude Code + DeepSeek + OpenCode Go" 从源码运行: bash git clone cd existingsolutionfinder npm install npm run build npm start "reasoningcontent error with Claude Code + DeepSeek + OpenCode Go" 安全边界 这个工具不会: 自动安装搜索到的工具 自动 clone GitHub 自动执行未知脚本 保证推荐结果一定正确 替代人工安全审查 它更像是一个“问题到已有方案”的发现器,帮助开发者在重复造轮子之前,先看看社区里是否已经有可用工具、issue、npm 包或 workaround。 项目状态 目前已经支持: CLI 使用 npm 全局安装 mock 模式 GitHub real search README 元数据提取 中英文输出 结构化评分 安全风险提示 后续计划: 更好的 GitHub issue 搜索 更好的 npm/package registry 搜索 更丰富的真实错误日志样例 更好的证据提取和中文输出 GitHub: npm:
Original—
Moono AI 帮你写歌 - 免费AI音乐生成器
完全免费、不需要登录、无广告的AI音乐生成器 Moono AI 帮你写歌 生成一首歌大概需要2分钟左右,可提供歌词或自动生成歌词。生成歌曲为MP3格式,可直接下载。 因为模型算力的原因,有时会生成失败,可能需要多试几次。
Original—
造梦工厂-基于火山引擎的全能视频工厂,萌宠、口播等爆火视频全流程制作
造梦工厂开源版V1.0正式上线,朋友们,玩儿起来吧! 造梦工厂是一个基于 Next.js 开发的 AI 多模态视频生成平台,专注于将创意转化为高质量的视频内容。全面接入火山引擎(Volcengine)的大模型能力,实现从文案分镜到图像生成,再到视频渲染的全链路自动化。 核心功能 萌宠视频生成 (AI Pet Video) 智能分镜:输入故事主题,调用大语言模型自动生成详细的分镜脚本和运镜提示词。 一致性生图:结合全局角色设定,使用 Seedream 生成各分镜的角色底图,保证长相和画风的一致性。 多镜头叙事:串联 Seedance 2.0 图生视频能力,配合各分镜的运镜提示词,完成连贯的多镜头叙事视频。 精细化控制:支持对单个分镜的图像或视频进行单独重新生成(Retry),拒绝“一子落错满盘皆输”,极大节省时间和成本。 口播视频生成 (Oral Video) 智能长文案切分:输入长篇口播文案,自动按字数和语义停顿切分为短视频脚本。 固定人设:每段使用相同的 assetId、人设模板和镜头模板,保持口播人物形象绝对稳定。 时长自适应:每段视频时长可单独控制(支持 415 秒)。 自定义视频生成 (Custom Video) 提供高级的视频生成沙盒,直接调用 Seedance 2.0。 支持自由配置:提示词、首尾帧参考图、视频比例、分辨率和视频时长,满足专业创作者的定制化需求。 任务历史与工作流 历史记录:所有生成记录保存在浏览器 LocalStorage 中,随时回顾。 一键复用:在历史记录中可以一键带入之前的配置参数,快速开始新的生成。 无水印与带音频:底层 API 深度优化,生成的图像和视频均去除了官方的水印,并支持开启 TTS 音频合成功能。 演示网站: Github:
Original—
CyberVerse:一张照片,生成能和你实时视频通话的AI数字人
Go CyberVerse 是开源的数字人智能体平台,支持实时视频通话。你可以创建一个能看、能听、能面对面交流的 AI 智能体,体验与真实视频通话无异。 一张照片,让数字人真正「活」起来。 你是否想过拥有一个属于自己的 J.A.R.V.I.S.——能真正看见你、听见你、陪伴你的 AI? 想再次见到思念之人,听见 TA 的声音,看见 TA 对你微笑? 又或者,你一直想把某个角色带到现实世界中? 只需一张照片,CyberVerse 就能让 TA 「活」过来。 亮点 实时视频通话 不是预录视频,也不是回合制交互,而是与数字人进行无限时长、低延迟的实时视频通话,首帧约 1.5 秒。底层基于 WebRTC,支持 P2P 流传输,并内置 TURN / NAT 穿透能力。 数字人即 Agent 数字人不只是一个能和你对话的形象,更是一个真正能帮你做事的 AI。 一张照片即可生成 上传一张照片即可创建数字人。由行业最新的数字人模型提供实时面部动画、自然口型同步与待机呼吸感,无需 3D 建模或动作捕捉。 自由组装你的 Agent 大脑、面孔、声音、听觉——各模块可插拔。通过 YAML 即可组合 LLM、TTS、ASR 与 Avatar 后端。 演示 <div align="center" | | | |::|::| | 爱丽丝 — 在 YouTube 观看 | 丽娜 — 在 YouTube 观看 | | | |::| | 小龙女 — 在 YouTube 观看 | </div
Original
—
linthis:一条命令搞定多语言 lint / format / 安全 / 复杂度检查的 Rust 工具
Rust 一条命令搞定多语言 lint、格式化、安全扫描的 Rust 工具 linthis 是一个用 Rust 写的跨平台多语言 Linter & Formatter,把 ruff、eslint、clippy、golangcilint、clangtidy、ktlint 等十几种工具封装在统一的命令行后面,一条 linthis 即可同时跑 lint、格式化、安全扫描(SAST)和复杂度分析。它支持自动识别项目语言、基于 Git 仓库分发团队规范的插件系统、git hook 与 AI agent hook(Claude Code / Cursor / Codex 等),适合多语言项目、monorepo 以及希望把代码规范沉淀成可版本化配置的团队,让新成员一行命令就能拿到完整的代码风格与质量门槛 亮点 一条命令多任务:lint + format + security + complexity 一次跑完,不再为每种语言单独配工具。 17+ 语言开箱即用:Rust / Python / TS / JS / Go / Java / C / C++ / Swift / Kotlin / Lua / Dart / Shell / Ruby / PHP / Scala / C 自动识别,无需手动指定。 基于 Git 的插件系统:团队规范打包成一个 Git ,linthis plugin add 一行同步给所有人,告别"每个项目重复配 .eslintrc / pyproject.toml"。 AI 友好:内置 linthis review 跑 diff 生成评审并自动开 PR/MR;hook 可挂到 Claude Code、Cursor、Codex、Gemini 等 AI 编程助手上,失败后让 AI 按规范自动修复。 安全 + 复杂度门禁:内置密钥泄漏检测,集成 OpenGrep / Semgrep / Bandit / Gosec / Flawfinder,函数级圈复杂度 / 认知复杂度可设阈值卡 CI。 Rust 性能 + 单文件缓存:多核并行处理,重复检查只跑变化文件。 撤销友好:format 自动备份,linthis backup undo / redo 一键回滚,保留 git patch 便于 review。 编辑器全覆盖:官方提供 VSCode、JetBrains、Neovim 插件,支持 Format on Save。 markdown 安装(推荐 uv) uv tool install linthis 添加团队规范插件 linthis plugin add g sample 安装 git + AI 自动修复 hook linthis hook install g type gitwithagent provider claude 检查并格式化指定目录 linthis i src/ 提交前只检查 staged 文件 git add src/main.py linthis s AI 代码评审 + 自动开 PR linthis review autofix 截图或演示视频
Original—
Plexus —— 一键同步 Claude Code、Cursor、Codex 等 AI Agent 配置
人工智能 Plexus —— 一键同步 Claude Code、Cursor、Codex 等 AI Agent 配置 Plexus 是一个本地 AI Agent 配置控制台,可以把 Rules、MCP Servers 和 Skills 一键同步到 Claude Code、Cursor、Codex、Gemini CLI、Qwen Code 等常用 AI 编程工具。 Dashboard 为什么做这个 现在很多开发者不会只用一个 AI 编程工具:可能用 Claude Code 做规划,用 Cursor 写代码,用 Codex 跑自动化,再偶尔切到 Gemini CLI 或 Qwen Code。 但每个工具都有自己的配置文件、MCP 格式、Skill 目录和指令文件。一个 MCP Server、一个 skill、一个 CLAUDE.md 规则,经常要复制到好几个地方。时间久了之后,很容易出现 drift:不知道哪个工具里的配置才是最新的,也不知道一次同步到底改了哪些文件。 Plexus 想解决的就是这个问题:让本机有一个 AI Agent 配置的 single source of truth。 工作原理 Architecture Plexus 不强行让所有 AI 工具使用同一种格式,而是保留每个工具自己的原生文件: Rules:把一份 global.md 投射到 CLAUDE.md、AGENTS.md、GEMINI.md Skills:用目录级 symlink / copy 同步到各个 Agent 的 skills 目录 MCP:对 Cursor 这类专用 MCP 文件使用 symlink;对 Claude Code、Codex 这类共享配置文件只 partialwrite MCP section,保留 auth、history、profile 等原生内容 支持的 Agent Claude Code Cursor Codex Gemini CLI Qwen Code Factory Droid Settings 里也内置了 Windsurf、Kiro、VS Code Copilot、Cline、Roo Code、Continue、Aider、OpenHands、Zed AI 等常见工具的手动登记入口。 技术栈 TypeScript Next.js Node.js 本地文件系统同步 Symlink / partialwrite / backup snapshot 亮点 一键导入已有配置:从 Claude Code、Cursor、Codex 等工具读取现有 Rules、MCP Servers 和 Skills。 一键同步到所有 Agent:把共享配置投射回每个工具的原生路径。 支持 Primary Agent:如果多个工具里有同名配置冲突,可以选择以哪个 Agent 为准。 本地优先:所有配置放在 ~/.config/plexus/,不依赖云端服务。 安全回滚:每次写入 Agent 原生文件前都会自动创建 snapshot。 支持团队配置:可以订阅一个 Git ,分发团队共享的 rules、skills 和 MCP baseline。 支持手动新增 Agent:如果某个新 AI 工具还不在内置列表里,可以在 Settings 里登记 instruction file。 markdown 截图或演示视频
Original—
HabiLife
Building the future of Social Fitness

—
Bloom: New Parent Wellness
Wellness and habit tracking for new parents
—
LivingTrail
Find and compare senior living communities easily
—
Tably
The operating system for modern restaurants
—
FortSignal
You Approve the Action. We Enforce It.
—
Montera
99 sports. One leaderboard. Real prizes. Effort wins.
—
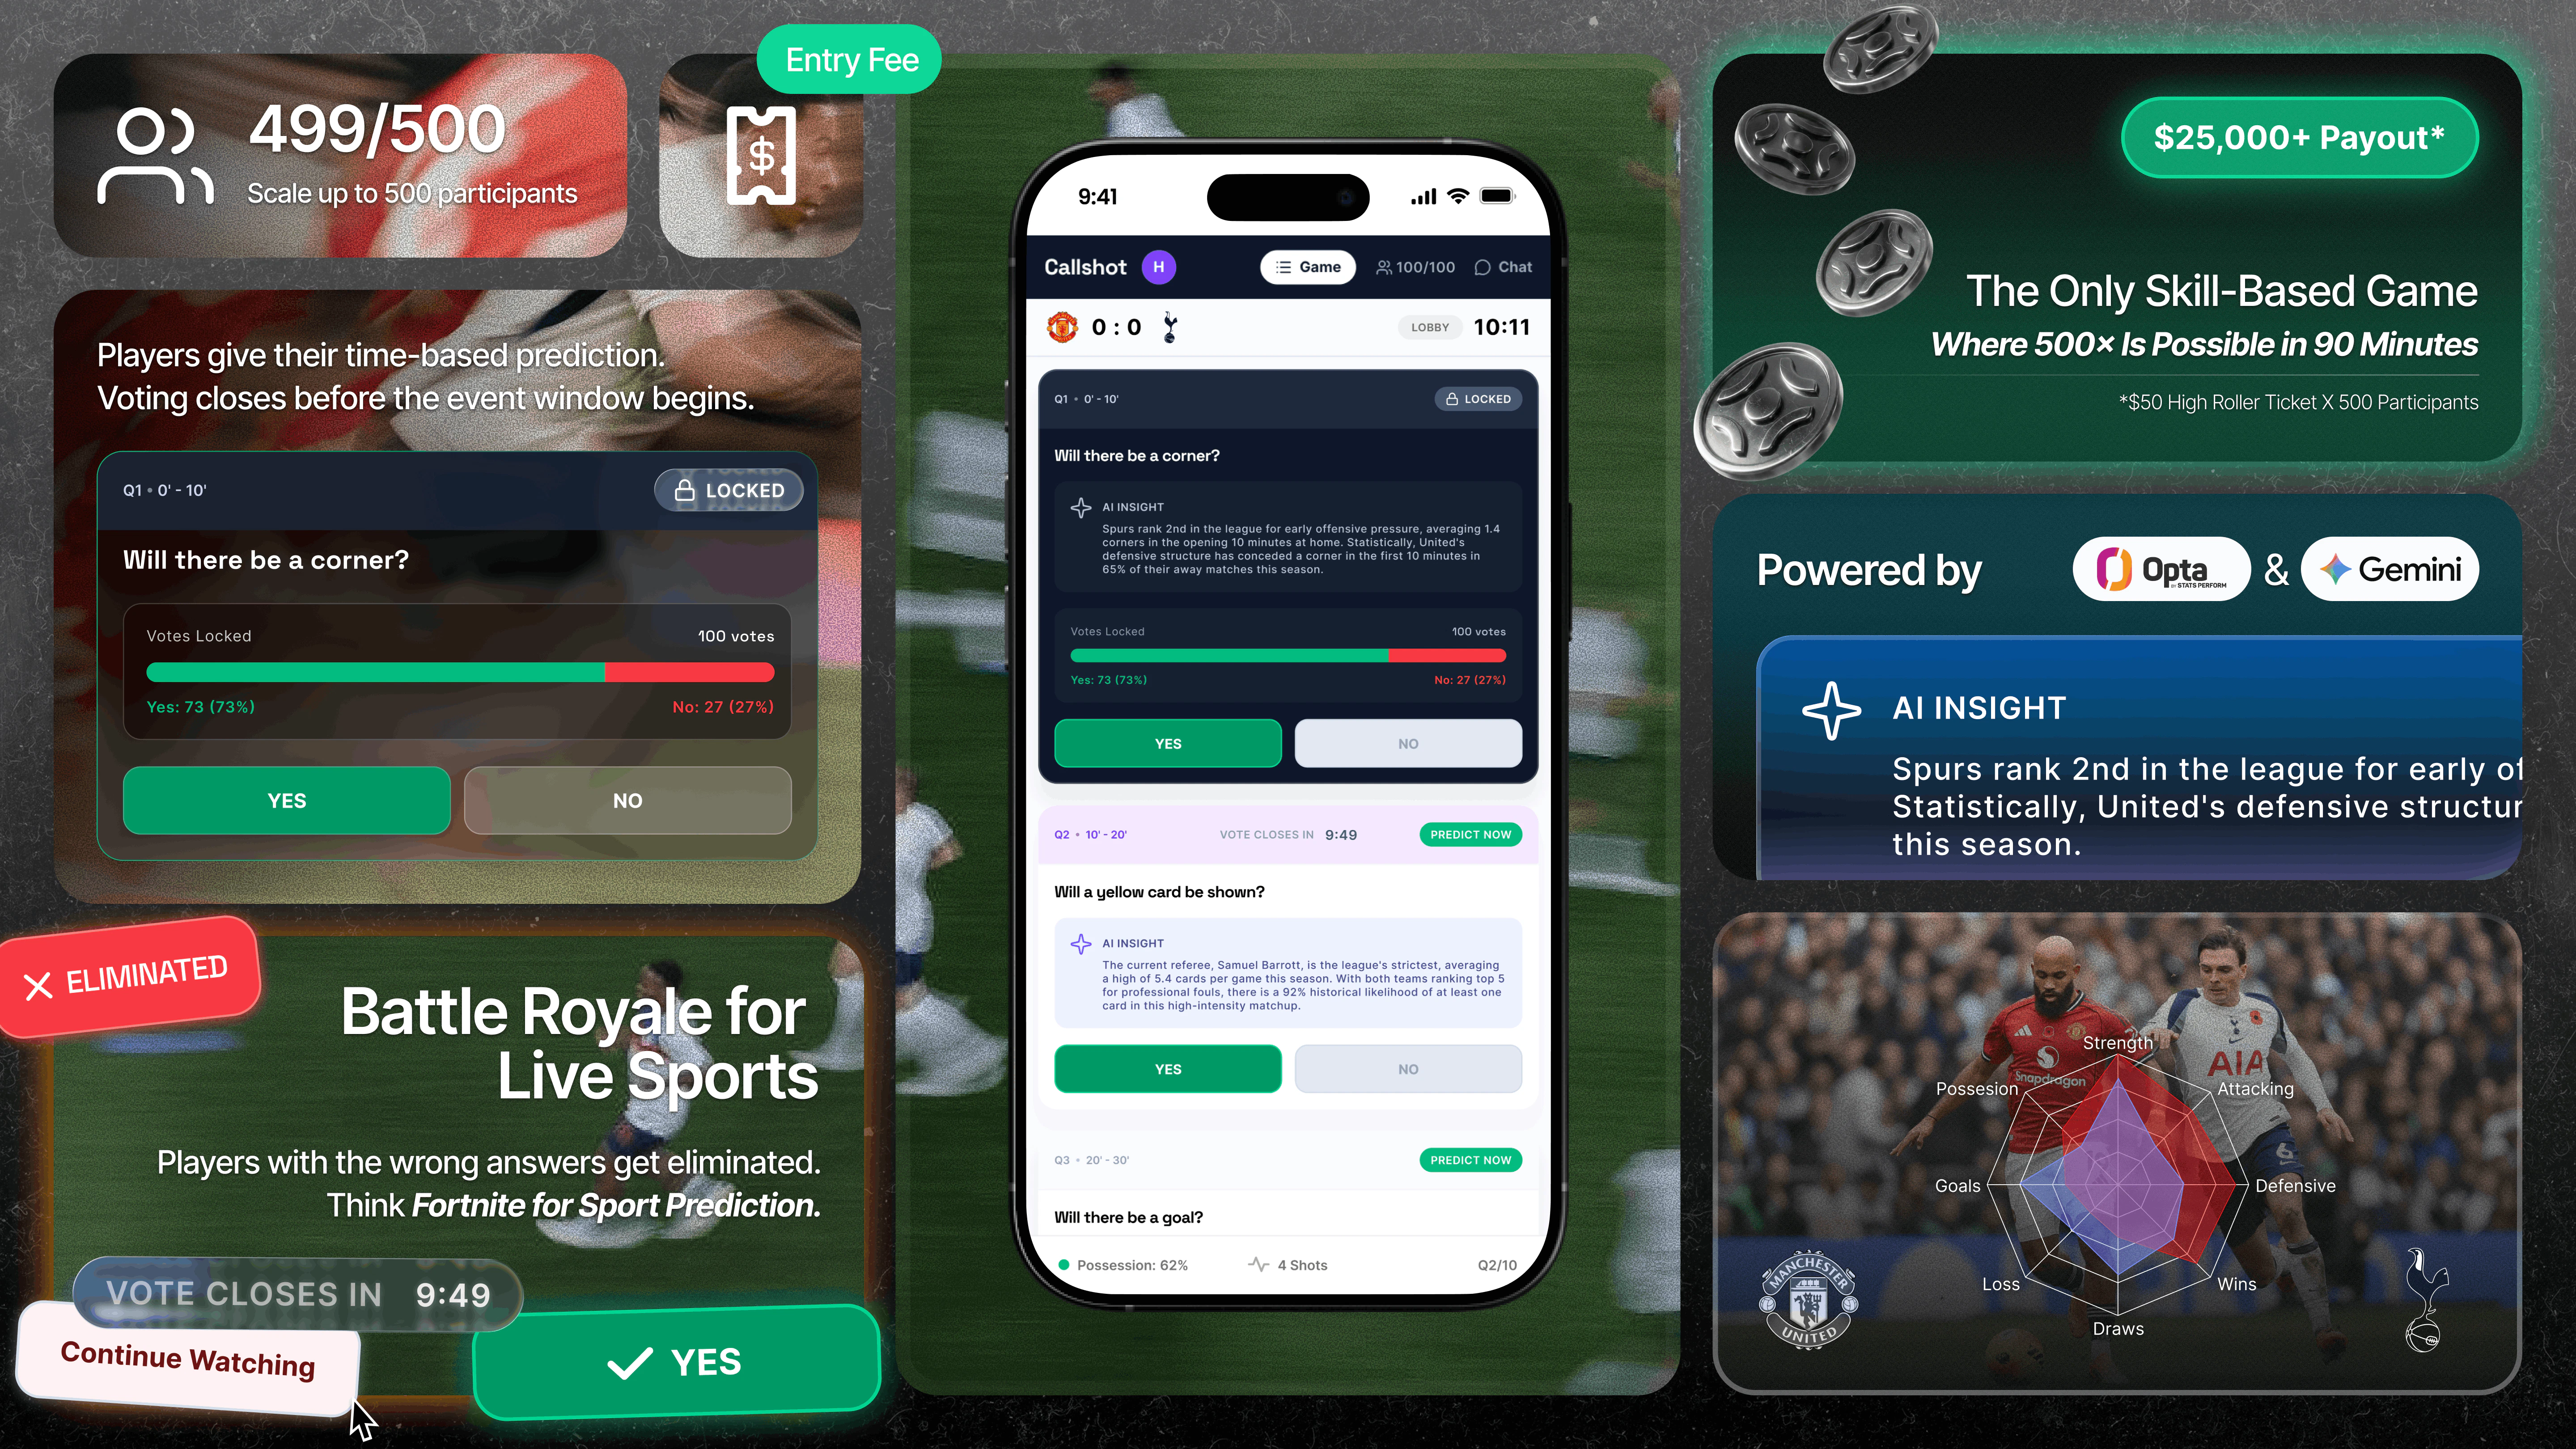
Callshot
HQ Trivia meets Sports Predictions
—
IteraSuite
Fast, secure, and fully browser-based tools
—
ProRemover
Remove objects, text, backgrounds, and watermarks online .
—
Lnkk.it
Turn engagement into conversions.
—
Boston Car Service
Boston car service - Boston limo service
—
QR Tiger
The most advanced digital business cards for lead generation
—
WrightAI
Documentation Intelligence Platform, ensures code never lies
—
ChatbotsHub
Turn your documents into AI chatbots
—
Two Pencils Design Studio
Most websites don’t convert. We fix that.
—
Invite Only
The event invite that actually gets people to show up
—
Gemini Deep Research Agent
Web and MCP research agents, now in Gemini API
—

The Covenant App
Covenant gives couples a record of what they built together
—
NewlyRegisteredDomains.io
Search newly registered domains easily and for free
—
omaxebetogather.com
Omaxe Centre Amausi Lucknow | Commercial Shop Near Airpor
—
No matching projects
Try another keyword or category.
DEV TRENDS / COMMUNITY
Discuss this edition
Sign in with GitHub to share a thought, question, or useful follow-up.