
—
DEV TRENDS / DAILY DISCOVERIES
Jun 25, 2026 · What developers are building
Daily discoveries from developer communities, independent makers, and open source.
—
—

—
—
—

—
AI Product Scout:AI 产品商业化案例库
AI Product Scout 项目简介:AI Product Scout 是一个 AI 产品商业化案例库,整理 AI 产品、垂直行业、商业模式、增长路径和产品定位分析。站点把本地研究稿整理成公开文章库,支持中英文页面、搜索、标签过滤和稳定链接,适合关注 AI 产品、独立开发、SaaS 出海和商业化案例的读者参考。 内容不是工具黄页,而是偏案例研究和产品拆解,覆盖医疗、法律、营销、开发者工具、企业效率、消费应用等方向。 中英双语 SEO 和标签体系方便检索历史案例。 对独立开发者和产品经理来说,可以作为观察 AI 产品商业化路径的资料库。 作者:Alex Carter
Original
—
anti-vibe-writing:去除 AI 写作味,让你的AI文案倍儿地道的 Agent Skill
【开源自荐】antivibewriting:去除 AI 写作味的 Agent 写作技能 < antivibewriting 是一个用于去除“AI 写作味”的开源 Agent 写作技能。 现在很多人已经习惯用 AI 起草文章、帖子、README、产品文案、技术文档或内部报告。但 AI 生成的文字常常有一种很明显的模板感:过度分点、满屏 Markdown、空泛总结句、咨询腔、翻译腔、破折号滥用,以及那种“看起来很完整,但不像真人写的”的味道。 这个项目想解决的就是这个问题。 它不是一个单纯的 prompt 集,也不是所谓“AI 检测绕过工具”,而是一套可以接入 Agent 工作流的写作风格校正层。Claude Code、Codex 或其他 Agent 先完成初稿之后,再由它做最后一遍清理:在尽量不改变原意和事实的前提下,去掉明显的生成式痕迹,让文本更自然、更干净、更像人写的。 项目目前支持中英文,并针对两种语言分别整理了常见的 AI 写作痕迹。 中文部分重点处理: “赋能、打通、沉淀、抓手”等模板化表达 “首先、其次、最后”式机械分层 “不是……而是……”式 AI 常用对仗 欧化句式和翻译腔 过度四字词、过度总结、过度升华 明显不像真人会在社交平台上写出来的句子 英文部分重点处理: generic AI tone templated phrasing overstructured Markdown fake balance corporate / consulting voice em dash overuse Reddit / forum 场景里容易被看出 AI 痕迹的表达方式 它的一个特点是:不只做“变口语化”,而是区分不同写作场景。 目前内置了几类场景预设: X / Twitter 微博 / 中文短帖 Reddit / 英文论坛评论 博客 / Newsletter / 公众号 播客 show notes / 视频脚本 README / 产品文档 技术备忘 / 内部报告 / 提案 不同场景的目标不一样。社交媒体要像真人随手发,README 要清楚但不堆格式,技术备忘要保留判断和密度,Reddit 评论则要更像一个人在认真帮忙,而不是 AI 账号在回答问题。 另一个比较有意思的点是,它提供了三种声音模式: 1. 默认干净模式 适合大多数文档,只做去模板、去冗余、去 AI 腔。 2. 人味儿质感模式 适合个人博客、创始人笔记、社交媒体。会在合适的位置保留一点真人写作的节奏,比如短句、残句、语气转折,但不会故意制造错误。 3. 学习模式 可以根据用户提供的真实写作样本,提取一份可复用的 host profile,让后续文本更接近某个具体作者的声音。 我觉得这个项目的核心价值在于:AI 写作越来越普及之后,“会不会生成”已经不是问题,“生成之后像不像人写的”开始变成问题。尤其是中文内容里,AI 痕迹非常容易被看出来。很多时候不是观点不对,而是语言太像系统组装出来的。 antivibewriting 把这些经验整理成了一套可以复用、可以迭代、可以放进 Agent 工作流里的规则。 它本质上是一套 Markdown 规则文件,不绑定具体平台。可以 clone 仓库使用,也可以直接把 SKILL.md 和相关 references 放进自己的 Agent 上下文、项目指令或自定义 prompt 里。 项目采用 MIT 协议开源,欢迎试用和提建议。
Original—
TUI-easy-past:清理从终端 / TUI 复制出来的乱码式文本,一个指令让TUI文案粘贴更简单
【开源自荐】tep:清理从终端 / TUI 复制出来的乱码式文本 < tep 是一个很小的命令行工具,用来清理从终端或 TUI 程序里复制出来的文本。 现在很多开发者开始在 Claude Code、Codex CLI、lazygit、vim、fzf、htop 这类终端界面里工作。但从这些界面里复制内容时,经常会遇到一个很烦的问题:粘贴到 X、Reddit、GitHub Issue、文档或聊天窗口之后,文本格式全乱了。 常见情况包括: 每一行前面都带着 TUI 的缩进 原本一段话被终端硬换行切成很多短行 表格、边框、竖线、框线符号一起被复制出来 ANSI 颜色控制符混进文本 Markdown 结构被破坏 代码块和普通段落混在一起,粘贴后很难读 tep 解决的就是这个小痛点。 它的使用方式很简单:在 TUI 里正常复制文本,然后运行 tep。它会读取系统剪贴板,自动清理内容,再把清理后的文本写回剪贴板。之后直接粘贴到任何地方即可。 这个工具比较适合经常使用 Claude Code、Codex CLI 或各种终端工具的人。比如你在 Claude Code 里复制了一段回答,粘贴到 GitHub Issue、X、Reddit 或文档里,原本经常会出现一堆断行和缩进;现在只需要运行一次 tep,就可以得到干净的文本。 它的一个特点是会自动区分 Markdown 和普通文本: 普通文本:自动把终端硬换行重新合并成自然段落 Markdown:保留标题、列表、引用、表格、代码块等结构,只修复被终端折行打断的正文 代码块:尽量原样保留,不随便重排 边框和 TUI chrome:自动剥离 ANSI 转义符:默认清理掉 它不是一个复杂的大工具,而是一个很典型的“每天可能用好几次”的开发者小工具。尤其是在 AI coding agent 变成日常开发入口之后,很多内容都从终端窗口里产生,再被复制到网页、文档和社交平台。tep 相当于给这个复制粘贴链路补了一层清理器。 安装方式: go install github.com/weijt606/TUIeasypast/cmd/tep@latest 常用方式: tep:清理剪贴板并写回 tep dryrun:只输出清理结果,不修改剪贴板 tep explain:显示它检测到了什么、改了什么 tep markdown:强制按 Markdown 处理 tep plain:强制按普通文本处理 tep norejoin:只清理边框和缩进,不合并换行 项目使用 Go 编写,没有第三方依赖。macOS 可以直接使用系统自带的 pbcopy / pbpaste,Linux 支持 wlcopy、xclip、xsel,Windows 使用系统剪贴板命令。 我做这个项目的原因是:TUI 工具越来越多,AI coding agent 也越来越多,但“从终端复制到外部世界”这个动作仍然很粗糙。tep 想把这个小摩擦磨平。 项目采用 MIT 协议开源,欢迎试用和提建议。
Original—
「开源自荐」2026 世界杯实时战报 ⚽-worldcup-report
2026 世界杯实时战报 ⚽ 一个数据可实时更新的 2026 世界杯(美/加/墨,48 队)战报应用。体育热血风,覆盖八大板块,含 AI 冠军预测与球迷投票。 线上地址: 八大板块 | Tab | 内容 | ||| | 积分榜 | 12 组小组赛积分榜,前二晋级(绿)/ 最佳第三 8 席(金)高亮,顶部今日速递含进球队员 | | 射手榜 | 进球排序,前三领奖台,含点球数,中文名 + 国旗展示 | | 淘汰赛 | 近期赛程(按日)+ 冠军之路漏斗 + 依当前积分推演的晋级席位 | | 预测 | 9 维加权冠军预测模型(FIFA 排名 / 阵容身价 / 状态 / 底蕴 / 攻防 / 伤病 / 大赛经验 / 势头)+ 球迷投票(冠军/亚军/季军) | | 球队 | 点选球队看积分、近期战绩、核心射手,按分组折叠呈现 | | 数据 | 各组进球、各轮进球、射手榜 Top10(recharts)+ 关键指标 | | 战报 | 由真实比分模板化生成的中文战报,可按"爆冷/血洗/进球大战"等标签筛选 | | 精彩瞬间 | ABC News 专业赛事图集,灯箱浏览 + 照片点赞 | 数据架构 三级数据回退,确保任何环境都有数据: 前端每 60s 自动轮询 ↓ 后端 /api/wc/(Cloudflare Pages Functions) ├─ 1. footballdata.org 实时 API(收费版,含完整赛程/积分/射手) ├─ 2. Supabase 数据库缓存(自动同步 + 进球数据注入) └─ 3. data/snapshot.json 快照(离线兜底) Supabase 后端 | 表 | 用途 | ||| | wcdata | 积分榜 / 射手榜 / 球队名单缓存 | | wcmatches | 比赛数据(含进球详情注入) | | wcsyncmeta | 同步元信息(时间戳 / 数据源) | | gallerylikes | 照片点赞 + 应用全局点赞 + 冠军投票(复用表,键前缀区分) | 进球数据注入 footballdata.org API 的 matches 端点不返回 goals 字段。应用通过 Supabase 种子数据双策略注入进球信息: 策略 1:按 match ID 精确匹配 策略 2:按球队名对模糊匹配(种子数据 ID 10011072 vs live API ID 537xxx) 自动同步 通过 /api/sync 端点 + Cron Worker 定时拉取 footballdata.org 最新数据并写入 Supabase,保证数据库缓存始终最新。 冠军预测模型 9 维加权评分 + softmax 概率归一化: | 维度 | 权重 | 数据来源 | |||| | FIFA 排名 | 18% | FIFA.com(2026.06.11) | | 阵容身价 | 16% | Transfermarkt(2026.06) | | 小组赛状态 | 14% | footballdata.org 实时 API | | 世界杯底蕴 | 10% | FIFA 官方历史档案 | | 伤病跟踪 | 10% | ESPN / BBC / Sky Sports | | 攻击效率 | 8% | footballdata.org 实时 API | | 防守稳固 | 8% | footballdata.org 实时 API | | 大赛经验 | 8% | 世界杯冠军/决赛历史 | | 近 3 场势头 | 8% | footballdata.org 实时 API | | 东道主加分 | +4 | — | 所有知识库数据均来自公开可验证来源,未收录球队使用明确默认分,不做猜测。模型仅供参考娱乐。 球迷投票 预测页底部内置投票功能: 选择冠军 / 亚军 / 季军(三个名次不可重复) 提交后实时展示各名次 Top 5 球队得票分布 localStorage 防重复投票 乐观更新 + 失败回滚 快速开始 bash npm install npm run dev 环境变量 复制 .env.example 为 .env,按需填写: env FOOTBALLDATATOKEN=xxx footballdata.org API token(必填,实时数据) SUPABASEURL=xxx Supabase SUPABASESERVICEROLEKEY=xxx Supabase servicerole key(必填) SYNCSECRET=xxx /api/sync 鉴权密钥(可选) NEWSAPIKEY=xxx NewsAPI key(可选,精彩瞬间图集) 不配置也能跑 —— 自动回退到内置快照数据。 脚本 bash npm run dev 本地开发(Express + Vite 中间件) npm run build 构建前端到 dist/client npm start 运行生产构建 npm test 数据转换 / 战报生成单元测试 npm run lint tsc 类型检查 npm run snapshot 重新生成 data/snapshot.json 快照 npm run deploy 构建 + 部署到 Cloudflare Pages(Production) npm run collect 收集精彩瞬间图集到本地缓存 部署 项目部署在 Cloudflare Pages,使用 Pages Functions 提供 API: wrangler pages deploy dist/client projectname=worldcupreport branch=main Pages Functions 路由: /api/wc/[type] — 赛事数据(standings / scorers / matches / teams) /api/wc/gallery — 精彩瞬间图集 /api/wc/gallery/likes — 照片点赞 /api/app/likes — 应用全局点赞 /api/app/vote — 冠军投票 /api/sync — 数据同步(Cron 触发) 技术栈 React 19 · Vite 6 · Tailwind v4 · TypeScript · Cloudflare Pages Functions · Supabase · Express · recharts · motion · lucidereact 说明 数据仅供学习演示。国旗来自 flagcdn。
Original—
—
Show Me the Codes:给独立开发者展示产品的个人主页
showmethe.codes 示例主页:showmethe.codes/corey 很多独立开发者会同时做 SaaS、小工具、开源项目、newsletter、播客,但这些作品常常散在 X、GitHub、Product Hunt、个人博客和各种落地页里,很难用一个链接说清楚“我到底做了什么”。 Show Me the Codes 想做 indie hackers 的 linkinbio:每个 maker 可以认领一个用户名,得到 showmethe.codes/<you,然后把自己做过的产品放在一个 bento 卡片墙里展示出来。 主要功能: 认领唯一 username,生成公开个人主页; 用 bento 卡片展示产品 、地点和社交账号; 每个 maker 都有连续会员编号,例如 0001; 支持产品状态标记,比如 building、live、for sale、acquired; 支持中英文,深色 Tokyo Night 风格; 免费使用,Pro 一次性解锁自定义域名、访问统计、主题和去品牌标识。 这是我做的独立项目,面向 indie hacker、solopreneur 和 building in public 的开发者。欢迎大家认领自己的名字,也欢迎反馈还应该支持哪些展示方式。 Me the Codes OG
Original—
应时|赶集圩日通 一个知道赶集趁圩日历的微信小程序
<img width="1536" height="1024" alt="Image" src=" /
—
网站存档工具,扒掉js,把网站打包成一个可执行文件
kage(日语影的意思)会将一个网站克隆到一个文件夹中,供你离线浏览,并剥离其中的所有脚本。它会用真实的无头 Chrome 打开每个页面,等待页面加载稳定,对人类所看到的 DOM 进行快照,然后删除所有 JavaScript,并将 CSS、图片和字体下载到本地路径。最终落在磁盘上的内容看起来和线上网站一模一样,却不会运行任何代码。 有个问题你应该也遇到过。你在某个想保存的页面上点了"另存为",半年后再打开,却发现屏幕一片空白、加载圈永远转个不停,又或者那份副本还在试图连接一个早已不存在的服务器。这个页面其实从来就不属于你——它不过是别人 JavaScript 的一个瘦客户端。 kage 走的是另一条路。它驱动一个真实的浏览器,让页面完成它该做的一切,抓取最终结果,然后把所有脚本统统扒掉。没有追踪,没有网络请求,没有意外。剩下的只是 .html 文件——你可以直接从磁盘打开,发给朋友,或打包成一个文件,然后尘封十年。 完整文档和指南位于 kage.tamnd.com。
Original—
使用六边形架构理念实现的书签管理工具,支持导入chrome书签文件
📖 Bookmark Manager 一个基于 Rust 生态构建的高性能、轻量级书签管理 Web 应用。 用户名:guest 密码:guest 🚀 特性 极致性能:基于 Rust 的 axum 框架与 PostgreSQL 构建,内存占用低、响应速度快。 现代化全栈体验:结合 htmx 与 askama 模板引擎,无需引入重量级前端框架即可实现无刷新的动态交互。 优雅 UI:采用 TailwindCSS 构建,界面现代、布局响应式。 生产级部署:内置开箱即用的 Nginx、Systemd 配置,并支持多环境配置分离。 🛠️ 技术栈 后端:Rust(axum) 数据库:PostgreSQL + Redis(用于缓存与会话管理) 模板引擎:Askama(编译期类型安全的 HTML 模板) 前端:htmx + TailwindCSS + Bun(构建期工具)
Original—
一个在网页上加上文字水印的chrome插件,支持中英文,
我本身是一个测试,遇到一个问题是,在网页端测试时,要区分测试or生产环境,在生产环境操作数据时,需要额外小心 所以想着可以在页面上加一个水印,提醒自己在生产环境谨慎操作
Original—
—
CyberVerse:开源实时数字人 Agent 框架
CyberVerse 软件介绍 CyberVerse 是一个开源的实时数字人 Agent 框架。 我做这个项目时,一直想解决一个很具体的问题:数字人不应该只停留在“生成一段视频”或“播放一个虚拟形象”的阶段。更有意思的状态,是你打开一个界面,选择一个角色,给它配置声音、人设、记忆和模型,然后它真的可以开始和你说话,可以被打断,可以接着聊,也可以在不同会话之间保留一点连续感。 所以 CyberVerse 更像一个数字人工作台:它把角色选择、角色编辑、离线生成和实时通话放在同一个系统里。只需要一张参考图,就可以创建自己的角色;如果暂时没有本地 Avatar GPU,也可以关闭视频能力,把它当作纯语音 Agent 使用。 功能特性 角色工作台:支持创建、编辑和启动角色,可以配置形象、声线、角色描述、人设风格、欢迎语和系统提示词。 实时语音 / 视频会话:基于 WebRTC,支持麦克风输入、文本输入、语音打断和长会话恢复。 数字人视频:支持通过 FlashHead、LiveAct 等 Avatar 后端驱动实时头像视频,也支持待机视频和离线视频生成。 角色记忆与知识库:会话历史可持久化,支持导入文档、人物生平和知识材料,用 RAG 让回答更贴近角色。 PersonaAgent + SubAgent:前台 PersonaAgent 负责自然对话,搜索、整理、报告生成等耗时任务可以交给后台 SubAgent。 插件化模型配置:LLM、Omni、ASR、TTS、Embedding、RAG、Avatar 都可替换,通过 YAML 和 Web UI 配置不同厂商服务。 可退化到纯语音模式:没有 GPU 时也可以运行核心语音 Agent,不强依赖数字人视频链路。 功能预览 角色选择 进入 CyberVerse 后,可以看到一个角色库。每张卡片对应一个可启动的数字人角色:有偏真实的角色,也可以是动画角色;每个角色都有自己的声线、描述和启动入口。这个页面像是把角色从文件夹里请出来的入口,而不是只展示一组静态素材。 角色编辑 角色编辑页可以设置形象来源、角色名称、角色描述、语音模型、人设风格等。这里想解决的是数字人常见的“空壳感”:它不只是图片会动,还应该知道自己是谁、用什么声音说话、以什么语气陪你聊天。 Workspace / 离线生成 Workspace 支持文本驱动和语音驱动,可以先用脚本生成视频,也可以调整输出设置后再进入实时会话。它更像一个创作台:先把角色、声音、画面调到合适的状态,再让角色进入更自然的交互。 实时通话 实时通话界面左侧是数字人视频,右侧是对话记录,底部可以直接语音输入。这个部分花了很多精力处理 WebRTC、音画同步、待机视频与说话片段衔接。因为只有当一个数字人能及时回应、能被打断、长聊时不掉上下文,它才不只是“生成出来的视频”,而更像一个可以一起相处的 Agent。 CyberVerse 还很早期,很多地方仍在继续打磨。但我希望它能成为一个可以自己搭建、自己调角色、自己接模型的实时数字人系统。欢迎对语音 Agent、数字人、虚拟角色和 WebRTC 感兴趣的朋友试用和交流。
Original—
版式建议:在微信版的期刊上为文中链接生成二维码小图片
在《科技爱好者周刊》的微信号中,文章中的网址没有做成超链接的形式,读者无法直接点击,这可能是平台有所限制? 我在其他电子期刊中看到一种处理方法:为文中的网址生成二维码的小图片,附加在每一个段落后。读者只需要长按图片,就会弹出‘识别二维码’的菜单,即可打开链接。 因地制宜。
Original—
一个根据位次自动匹配冲/稳/保志愿的微信小程序——志愿鲸AI。
解决的问题:高考出分后,面对几千所院校和海量录取数据,家长和学生往往不知道自己的分数"能上什么学校"。 核心功能:输入分数 + 省份 + 选科,自动换算等效位次、匹配历年录取数据,输出冲/稳/保三档院校推荐。每所学校还能展开查看具体专业的录取分数和招生计划。 数据来源:爬取了百度高考 3000+ 高校的历年录取数据,覆盖各省份、各科类的院校分数线、专业分数线、一分一段表和招生计划。 几个设计上的点: 1:使用位次匹配而非简单分数比对——分数年年变,位次才是稳定的锚点。 2:冲/稳/保三档按分差自动归类(冲:历年分差 < 0,稳:0~5 分,保: 5 分)。 3:支持 3+3 和 3+1+2 两种高考模式的选科匹配。 微信扫码或搜索「志愿鲸AI」体验。
Original—
GoldMonitor,本地运行的黄金价格监控与预警工具
GoldMonitor 是一个本地运行的黄金价格监控工具,提供 Windows 桌面版和 macOS DMG 安装包,用于查看国际金价、人民币克价和 USD/CNY 汇率,并设置本地预警。 主要特点: 实时显示 XAU/USD、人民币克价和 USD/CNY 汇率,并展示数据源、更新时间和缓存状态。 支持上涨、下跌、关键价位和短时波动提醒,可配置弹窗、声音、邮件和 Webhook 通知。 支持目标价观察清单,可以维护多个人民币克价或国际金价目标。 支持本地持仓看板,维护人民币克价和国际金价持仓,自动计算成本、市值、浮动盈亏,并导出 CSV。 支持本地价格历史、复盘时间轴、图表事件标记、CSV 导出和本地复盘报告。 配置和持仓数据保存在本机,敏感配置优先写入系统凭据存储。 适合关注黄金价格、需要桌面预警工具,或者希望本地记录贵金属持仓盈亏的用户。 最新发布版本:
Original—
ARES —— Go 语言生产级自愈多智能体运行时
大家好,我是 ARES 的作者 Timwood0x10。 ARES(Adaptive Resilient Evolution System)是一个用纯 Go 实现的生产级 MultiAgent Framework,专注于解决当前 Python Agent 生态在高并发、系统韧性、生产部署和持续进化上的痛点。它不是简单拼装 LangChain 式工具,而是从协议层到基础设施层完整自研的运行时。 核心亮点 动态编排引擎(MutableDAG):支持运行时热变更(运行中随意添加/删除节点和边,耗时 <1μs),内置拓扑排序、增量循环检测和热重载。工作流可以根据实时情况动态调整,而不需要重启或停止执行。 Agent 自愈与复活机制:完整的 Leader Failover + Agent Resurrection 能力。Leader 崩溃后自动通过 checkpoint 恢复任务并重新分配;任意 Agent 崩溃也能自动检测并复活(支持 pluggable health check),结合事件溯源(Event Sourcing)实现双维度(操作 + 认知)恢复。 混沌工程 Arena:内置故障注入框架,支持 processkill、networkpartition、latencyspike 等多种真实故障测试,并给出 Resilience Scoring。支持 Survival Mode 持续压力测试,让系统在混沌环境中验证和提升韧性。 自主进化(遗传算法):集成多代种群进化引擎(Selection + Crossover + Mutation),通过 Arena 回归测试 + Welch’s ttest 评估策略优劣,实现 Dream Cycle(触发→变异→评估→采纳→记录谱系)。支持 Elite Preservation 和 Bandit 反馈循环,持续优化 Agent 决策质量。 其他关键能力还包括: 自研 AHP 分布式协作协议(心跳、死信队列、背压) 三级 Memory Distillation 流水线 + pgvector 向量记忆 MCP 协议完整支持 + OpenTelemetry 可观测 + Web Dashboard 可插拔存储(PostgreSQL + pgvector 生产就绪,其他后端一键切换) 基准测试:大量热路径 <1μs,零分配关键操作,race 全通过 有详细的 READMECN.md 中文文档、dockercompose 一键启动,以及大量 advanced examples(包括 dynamic dag、agent resurrection、autonomous evolution 等)。 目前迭代到 v0.2.3,欢迎大家 Star、试用、提 Issue 或 PR。特别适合对生产级可靠 Agent 系统、动态工作流、容错自愈感兴趣的同学或团队交流。 谢谢大家!
Original—
AI Agent Map:一张帮你选择 AI Agent 工具的地图
【开源自荐】AI Agent Map:一张持续更新的 AI Agent 生态地图 Agent Map banner < AI Agent Map 是一个面向开发者和 AI 产品使用者的 AI Agent 选型地图,也是一个周更、持续维护的 AI Agent 生态观察项目。 现在 AI Agent 生态变化非常快。Claude Code、Codex、Cursor、Cline、Devin、OpenHands、LangGraph、CrewAI、n8n、AutoGPT、Agent Zero 等工具和框架层出不穷,但真正要选择时,很多资料只是在堆链接,或者单独介绍某一个产品,很少回答更实际的问题: 我到底该从哪个工具开始? 这个项目想解决的就是这个问题。 AI Agent Map 不是一个单纯的 awesome list,而是一个偏“选型指南 + 生态周报”的知识库。它会按照使用场景、产品形态、能力边界和维护成本,把主流 AI Agent 工具放到同一张地图里比较,帮助读者更快得到一个合理 shortlist。 项目目前把 AI Agent 生态分成几类: 日常编码 Agent:Claude Code、Codex、Cursor、Cline、Windsurf、Continue 等 通用 / 多任务 Agent:Devin、OpenHands、AutoGPT、BabyAGI、Agent Zero 等 Agent 框架与平台:LangGraph、LlamaIndex、CrewAI、Haystack、Semantic Kernel、DSPy 等 Runtime 与工具层:Open Interpreter、LiteLLM、Pydantic AI、n8n、Flowise、MemGPT 等 Harness / Skills / Orchestration 相关项目:用于理解 Agent 背后的执行循环、技能系统和编排层 它的重点不是告诉你“哪个最火”,而是帮你判断“哪个适合当前任务”。 比如: 想做日常 coding,是选 Claude Code、Codex,还是 Cursor? 想要更强的自动化,是选 Devin / Jules 这类云端托管 Agent,还是本地 CLI Agent? 想自己搭建内部 Agent 系统,是该看 LangGraph、CrewAI,还是 Pydantic AI? 想理解 Agent 的底层执行结构,是该看 SWEagent、minisweagent、OpenHands,还是 OpenHarness? 想做工作流自动化,是该看 n8n、Flowise,还是直接写自己的 orchestration layer? 这个仓库希望提供的不是结论,而是一套比较框架。 项目里包含: AI Agent 生态地图 主流 Agent 项目目录 单项目介绍 使用场景指南 横向对比矩阵 能力维度拆解 每周 AI Agent 生态更新 最近热门项目观察 中英文内容入口 我觉得这个项目的价值在于:AI Agent 领域现在最大的问题不是缺少工具,而是选择成本太高。很多人第一次接触 Agent,会被各种名词绕晕:agent、workflow、runtime、framework、harness、skills、MCP、orchestration、memory、approval、sandbox、deployment……这些概念混在一起,很容易把“产品”“框架”“运行时”和“方法论”都混为一谈。 AI Agent Map 试图把这些东西拆开。 它会更关注几个实际问题: 这个工具适合什么任务? 不适合什么任务? 是产品、框架、runtime,还是 harness? 需要多少人工监督? 是否适合本地运行? 是否适合团队或企业环境? operator cost 高不高? 学习成本和维护成本如何? 它在整个 Agent 生态里处在哪一层? 最近一周有什么重要变化? 这个项目会保持周更,持续跟踪 AI Agent 生态里的变化。比如 .claude/skills 这类 skill layer 的兴起,Codex / Claude Code 这类 coding agent 的产品变化,以及开源 harness、runtime、workflow layer 的新项目。 我做这个项目的原因是:过去一年我自己一直在使用 coding agent、搭建 agent workflow,也在研究 metaharness、loop engineering 和 skillbased agent 架构。越深入越发现,AI Agent 不是一个单一产品形态,而是一整个正在快速分层的生态。对普通开发者来说,真正有用的不是再收藏一堆链接,而是有一张地图,知道自己站在哪里、下一步该看哪里。 AI Agent Map 就是想做这样一张地图。 项目采用 MIT 协议开源,会持续维护和每周更新。欢迎试用、补充项目和提交建议。
Original—
基于Cloudflare Serverless生态构建的实时 Web 聊天与通话应用
Live Repo: Room based,集成多人聊天、WebRTC 通话、Durable Objects 状态管理与 D1 数据库,提供低延迟、高可用的 Serverless 聊天体验。支持自行部署。
Original—
Tokenscope - 一款大模型调用tokens消耗、美刀消耗的dashboard
通过这个工具,你能知道智谱 lite Code plan 5h用量约等于20M,火山 pro Code plan 5h用量约等于70M
Original—
在线免费图片转像素工具:风格包括艺术风、黑白像素风、8-bit、16-bit、32-bit 像素风
No project description yet.
—
90+ 全屏免费在线全屏工具:恶搞全屏、时间全屏、OLED坏像素点测试全屏等等
<img width="2163" height="1203" alt="Image" src=" /
—
Gitoza - 本地优先、Git 驱动的 Rust+Tauri 测试用例管理客户端
项目官网(全球 CDN 直连): GitHub 项目简介 Gitoza 是一款使用 Rust + Tauri + React 开发的本地优先(Localfirst)测试用例管理客户端。 时至今日,仍有很多团队使用 Excel 管理用例,存在版本控制差、同步困难等痛点;而传统的云端 SaaS 工具通常较为臃肿、响应慢且费用高昂。此外,在 AI 辅助开发的今天,开发者用 Copilot 生成了大量用例,却仍需繁琐地手动复制粘贴到各效能平台上,导致工作流脱节。 Gitoza 提倡用例资产回归本地,将用例以标准的 YAML 文件形式存储在用户自己的 Git 仓库中。 核心特点 完全的数据主权:用例随代码走,100% 留在本地 Git ,无需担心数据泄露、断网或服务商跑路。 AI 工作流无缝闭环:在 IDE 里打开用例项目,可直接利用现有的 GitHub Copilot 或其他 AI 插件批量生成 YAML 用例,文件即用例,无需手动复制搬运。 基于 Git 的协同优化:借助 Git 的分布式特性解决多团队协同痛点,并在 UI 层面优化了冲突合并体验。 万级用例流畅渲染:底层由 Rust 驱动,前端采用虚拟滚动(Virtual Scrolling)技术。即使面对上千、上万个 YAML 小文件的变态并发读取,依然能保持毫秒级流畅响应,绝不假死。 本软件对国内的所有大小团队和同行完全免费开放,100% 纯净、无广告、无后门,仅在启动时检测并自动升级。欢迎大家提供压测。
Original—
Amiyadyuti Ghosh
dyuti518@gmail.com Go AMIYADYUTI GHOSH Hello world I'm Amiyadyuti Ghosh 亮点 markdown 截图或演示视频
Original
—
Hello Amiya Ghosh
Project URL dyuti518@gmail.com Category Kotlin Project Title I'm Amiyadyuti Ghosh Project Highlights Hello world I'm Amiyadyuti Ghosh Example Code markdown or Videos
—
[Open Source]
Project URL dyuti518@gmail.com Category Kotlin Project Title dyuti518@gmail.com Project Highlights Example Code markdown or Videos
—
妙幕:本地媒体创作工作台,支持六大 ASR 模型的音视频字幕生成、翻译、校对、烧录工具
JS 妙幕:本地媒体创作工作台,字幕生成、翻译、校对、烧录 妙幕(SmartSub)是一款本地优先的桌面应用,帮你一站式完成「音视频转字幕 → 翻译 → 校对 → 合成」。所有转写都在本地完成,无需上传文件,隐私无忧;支持批量处理与 GPU 加速,可在 Windows / macOS / Linux 上运行。 支持 whisper.cpp、fasterwhisper、FunASR、Qwen3ASR、FireRedASR、以及本地 Whisper CLI 多种引擎 支持多达 17 家翻译服务商以及兼容OpenAI的ai服务商 亮点 1. 6 大 ASR 引擎自由切换,中文场景针对性拉满 打破了绝大多数本地字幕工具「只依赖 Whisper 系列」的同质化局限,原生集成 whisper.cpp、fasterwhisper、FunASR、Qwen3ASR、FireRedASR 5 种引擎,还支持调用用户自行安装的本地 Whisper CLI。 其中 FunASR、FireRedASR 均为中文识别表现更优的专项模型,对中文语音、方言(粤语)场景的识别精度显著优于通用 Whisper 模型。所有引擎都做了开箱即用封装:FunASR 等通过 sherpaonnx 原生库运行,fasterwhisper 自带独立 Python 运行时,用户无需手动配置开发环境,在应用内即可下载管理。 2. 全显卡厂商 GPU 加速,真正零门槛启用 这是同类工具中少有的「全场景加速」方案,彻底解决了非 N 卡用户只能纯 CPU 跑转写的痛点: NVIDIA 显卡支持 CUDA 加速,覆盖多个主流版本 AMD / Intel 显卡新增 Vulkan 后端,Windows/Linux 平台均可硬件加速 macOS Apple 芯片原生支持 Core ML / Metal 加速 同时做到了用户零配置:软件自动识别显卡型号、自动下载对应加速包、加载失败自动回退 CPU,无需手动安装 CUDA Toolkit 等复杂依赖。 3. 真正的全链路一站式闭环,无需跨工具跳转 从音视频导入到最终带字幕的视频输出,全程在单一软件内完成,覆盖完整工作流: 上游:多格式音视频批量转写、外部字幕文件导入 中游:17 种翻译服务、AI 一键润色、逐句对照视频的专业校对台 下游:硬字幕烧录 + 无损软字幕封装,支持字体、字号、颜色、描边、阴影、九宫格位置等全量样式自定义,搭配所见即所得实时预览 省去了用户在「转写工具 → 翻译工具 → 字幕编辑器 → 剪辑软件」之间反复切换的成本。 4. 翻译系统高度可定制,自由度远超同类 内置 17 个翻译服务,覆盖百度、谷歌、腾讯等传统机器翻译,以及豆包、DeepSeek、通义千问、Ollama 本地模型等大模型方案,兼容所有 OpenAI 格式的自定义接口。 更具差异化的是界面化自定义参数能力:用户无需修改代码,直接在图形界面中为每个翻译服务配置请求头、请求体参数,支持字符串、数值、布尔、数组等多种数据类型,还支持配置导入导出,高阶用户可以精细控制翻译效果,这在字幕工具中非常罕见。 5. 产品化完成度高,中文用户体验友好 摆脱了多数开源工具「功能堆砌、交互粗糙」的通病:采用任务式启动台设计,功能分区清晰,自带新手引导、命令面板、快捷键系统、任务活动中心;针对国内用户做了大量本土化优化,支持国内镜像源下载模型、夸克网盘安装包、Homebrew 一键安装,降低了国内用户的使用门槛。 markdown 截图或演示视频 主界面 | 视频合成(字幕烧录) | 字幕校对 | | | | | | |
Original—
AI 辅助长篇写作桌面应用
Go AI 辅助长篇写作桌面应用 桌面 AI 长篇写作系统。内置角色关系、伏笔回收、故事弧线、地点图谱、读者认知五维结构化记忆,AI 每写完一章自动检查状态变更,生成 Diff 等你确认。本地语义搜索不联网搜几十万字,安装包 <60MB,填 Key 即用,MIT 开源。 亮点 写完自动维护设定状态,不是一次性对话。 每章结束后 AI 强制自查:角色有哪些变化、伏笔该收了还是超时了、弧线推到哪个节点、读者认知从「未知」变「已知」了吗?生成 Diff 等你逐行审批确认。不用手动提醒 AI「记得更新人物状态」,系统自己推。 纯离线语义搜索,几十万字按意思搜。 内置 ONNX Runtime + BGE 中文语义模型,写完自动增量索引。搜「主角第一次展露能力」能找到相关段落,哪怕措辞完全不同。全程本地运行,不用联网。 Git 全版本管理,每次对话自动 commit。 所有 AI 改动生成 Diff 逐行对比,确认才写入,不满意一键 Revert。写作记录永远可追溯,不怕改坏。 30+ 工具 + 六套可视化面板,IDE 级工作台。 AI 自主调用角色查询、伏笔检索、前文搜索等工具,前端有细腻的六阶段执行动画。角色关系有向图、地点层级图谱、弧线泳道图、时间线等面板让创作世界一目了然。 7 个国产模型 Provider 开箱即用 + 8 个内置创作方法论。 填 DeepSeek/GLM/Kimi/Qwen/豆包/MiniMax/MiMo 的 Key 就能用。内置场景节拍、对白潜台词、悬念钩子、去 AI 味等 Skill,用 Markdown 就能写自己的方法论,热重载,零代码扩展。 markdown 截图或演示视频
Original—
—
—

AIdeals - AI 模型价格与能力全景对比
一站式 AI 大模型定价对比平台,覆盖 Claude、GPT、Gemini、GLM、DeepSeek 等主流模型。编程套餐订阅与 API 按量付费双维度对比,帮助开发者和企业找到最优方案。
Original—
—
—
xbtlin / ai-berkshire
AI 时代的伯克希尔:基于 Claude Code 的价值投资研究框架。巴菲特·芒格·段永平·李录四大师方法论 + 多Agent并行研究。| AI-era Berkshire: a value investing research framework built on Claude Code. 4 masters' methodologies + multi-agent adversarial analysis.
Original1.8K
mauriceboe / TREK
A self-hosted travel/trip planner with real-time collaboration, interactive maps, PWA support, SSO, budgets, packing lists, and more.
6.5K
every-app / open-seo
Open source alternative to Semrush and Ahrefs
2.4K
aws / agent-toolkit-for-aws
Official, AWS-supported MCP servers, skills, and plugins to help AI agents build on AWS
1.1K
alibaba / page-agent
JavaScript in-page GUI agent. Control web interfaces with natural language.
19.7K
IceWhaleTech / CasaOS
CasaOS - A simple, easy-to-use, elegant open-source Personal Cloud system.
34.7K
opendatalab / MinerU
Transforms complex documents like PDFs and Office docs into LLM-ready markdown/JSON for your Agentic workflows.
69.4K
Free-TV / IPTV
M3U Playlist for free TV channels
18.2K
NanmiCoder / MediaCrawler
小红书笔记 | 评论爬虫、抖音视频 | 评论爬虫、快手视频 | 评论爬虫、B 站视频 | 评论爬虫、微博帖子 | 评论爬虫、百度贴吧帖子 | 百度贴吧评论回复爬虫 | 知乎问答文章|评论爬虫
Original52.7K
ScottSloan / Bili23-Downloader
开源、免费、跨平台的 B 站视频下载工具,支持多线程加速、音视频分离、弹幕元数据获取、自定义命名与分类等功能。Open Source, Free, Cross-Platform Bilibili Video Downloader.
Original5.3K
yaklang / yakit
Cyber Security ALL-IN-ONE Platform
7.4K
39.1K
Evil0ctal / Douyin_TikTok_Download_API
🚀「Douyin_TikTok_Download_API」是一个开箱即用的高性能异步抖音、快手、TikTok、Bilibili数据爬取工具,支持API调用,在线批量解析及下载。
Original18.5K
12.9K
9.8K
shadow1ng / fscan
一款内网综合扫描工具,方便一键自动化、全方位漏扫扫描。(An intranet comprehensive scanning tool, enabling one-click automated, all-round vulnerability scanning)
Original14K
hiroi-sora / Umi-OCR
OCR software, free and offline. 开源、免费的离线OCR软件。支持截屏/批量导入图片,PDF文档识别,排除水印/页眉页脚,扫描/生成二维码。内置多国语言库。
Original45.6K
MaaAssistantArknights / MaaAssistantArknights
《明日方舟》小助手,全日常一键长草!| A one-click tool for the daily tasks of Arknights, supporting all clients.
Original21.7K
23.4K
MeetPoint
Find the city where everyone's flights are cheapest

—
Milestones
Native project planning app, now on Mac & with an MCP server
—

Dumqa
Stop Guessing What to Study Next
—
Glitchwatch — CI and deploy alerts
One webhook. Every CI failure in one inbox.
—
SHIVA
Guardrails for AI agents — proof, not promises
—
Aiall-Images
Aiall-Images | AI Image & Video Creation Platform
—
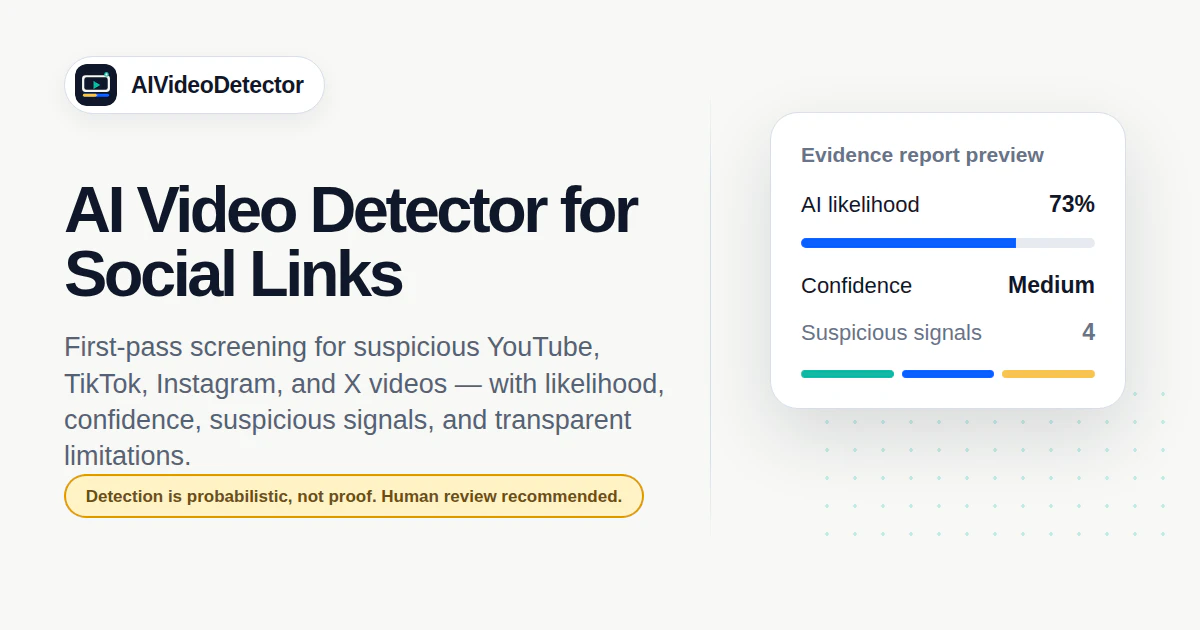
AI Video Detector
Check suspicious videos for AI signals
—
FetchTik
Download TikTok Videos Without Watermark - FetchTik
—
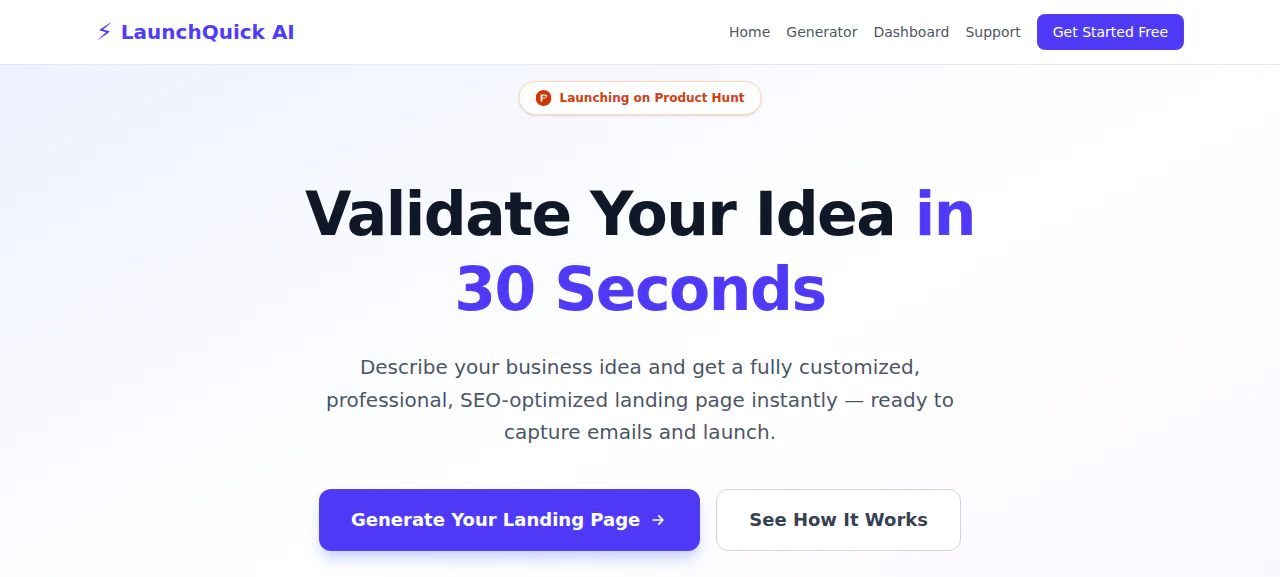
Launchquick.ai
Turn any business idea into a landing page in 30 seconds
—
GOMAX Ultimate
AI operating system for WordPress. One prompt, done.
—
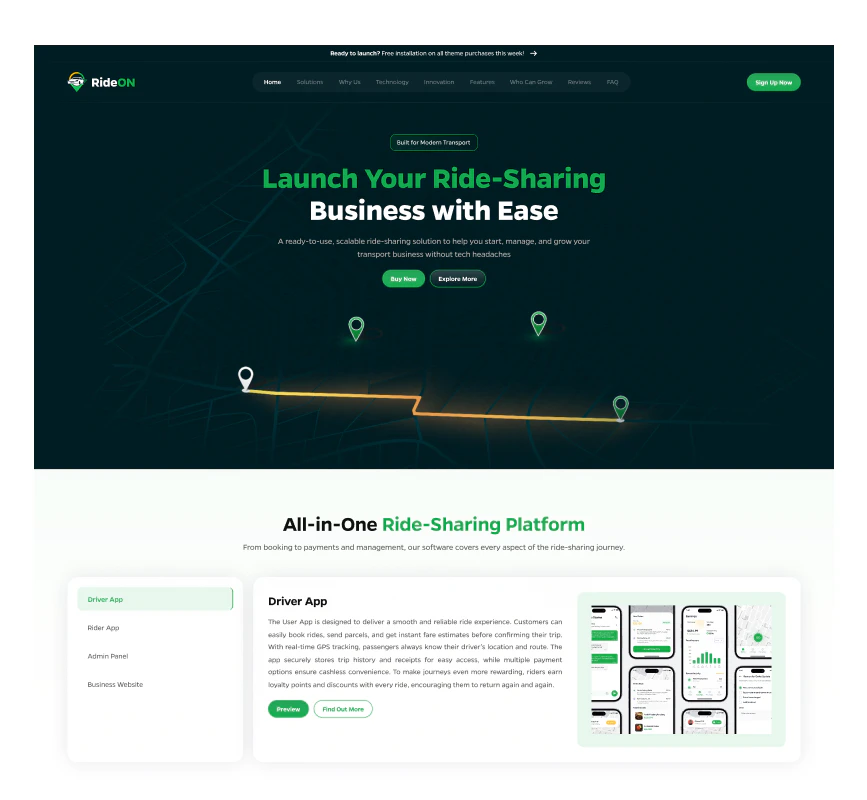
RideOn
Uber-Like Ride Booking Software for Startups
—
VTT for Mac
Voice-to-text for macOS with a fully on-device option
—
Pinpoint
Point your AI agent at the exact pixel you mean
—
Sequence Tool
Create What Matters - Toolkit for Final Cut & Resolve
—
Sven
SVN for WordPress developers — no terminal, free forever.
—
PeekCode
Instant code previews in Finder
—
CopyLucky
Local-first clipboard & utility workspace for macOS & iOS
—
ClipMind
Your Mac clipboard, with a memory and private AI
—
Count My Boxes
Inventory management you can set up this afternoon
—
MealGeni
AI meal planning that learns your family's tastes
—
No matching projects
Try another keyword or category.
Still trending3 highlights⌄
15 repositories were already featured in the last 3 reports, so they are not repeated in today’s discoveries.
calesthio / OpenMontage
World's first open-source, agentic video production system. 12 production pipelines, 100+ tools, 700+ agent skill and production-knowledge files. Turn your AI coding assistant into a full video production studio.
+3.6K stars today · seen in 1 of the last 3 reports
google-labs-code/design.md
A format specification for describing a visual identity to coding agents. DESIGN.md gives agents a persistent, structured understanding of a design system.
+1.4K stars today · seen in 1 of the last 3 reports
apple/container
A tool for creating and running Linux containers using lightweight virtual machines on a Mac. It is written in Swift, and optimized for Apple silicon.
+1.4K stars today · seen in 1 of the last 3 reports
DEV TRENDS / COMMUNITY
Discuss this edition
Sign in with GitHub to share a thought, question, or useful follow-up.